
Как использовать Jev, чтобы построить 24/7 HFT trading system
Полный русский перевод X Article о построении 24/7 HFT trading system на Jev: архитектура, state engine, risk layer, calibration и ограничения.

Источник: https://x.com/RohOnChain/status/2101311813908652069
Автор: Roan
Разберу точный framework для построения HFT trading system на миллисекундной скорости и 24/7 с Jev, вместе с ресурсами, которые лично помогли мне.
Сразу к делу.
Сохраните это: если вы строите HFT trading bots, подключайте своих агентов через AgenKit на agenkit.xyz. Он превращает один prompt в полноценную Quant Engineering Team, которая ship'ит production trading code. Начните здесь.
Если вы строите собственную trading system с Jev, напишите мне текущую setup в DM, и я лично разберу первые 10. Двигайтесь быстро.
15 сентября TypeSafe AI вышла из двухлетнего stealth с $40M под лидерством DCVC и выпустила новый класс AI-модели под названием Jev.
Основатель — Diogo Almeida, который в OpenAI был соавтором ChatGPT и InstructGPT.
Jev не генерирует текст.
Вы отправляете ему market state плюс типизированные вопросы, он возвращает calibrated decisions за 70-500 миллисекунд по цене $0,042 за миллион input tokens, output бесплатно.
Для trading эта latency — вся история.
LLM тратит 3-30 секунд, чтобы рассуждать об order book. К моменту ответа книга уже сдвинулась 40 раз.
Jev отвечает до прихода следующего block.
И доказательство, что это работает для trading, появилось в течение 72 часов после запуска.
Jarrod Watts запустил live market making bot на Monad: он читает Kuru MON-USDC order book, отправляет Jev decision каждый 300-миллисекундный block и выставляет реальный post-only limit order на один tick внутри touch.
1000+ stars за 3 дня. Решения за 81 миллисекунду. Live dashboard публично стримится.
Этот repo — existence proof.
Одну вещь важно понять до того, как идти дальше, потому что она формирует всё ниже.
Jev — decision engine. Но decision engine — это не trading system.
Кто-то всё ещё должен построить state engine, policy gates, risk vetoes и 24/7 loop вокруг него, причём production quality.
Именно для этого я использую AgenKit. Он превращает один prompt в полноценную quant engineering team, которая ship'ит код, к которому подключается Jev.
Jev принимает решения. AgenKit строит систему, которая его вызывает.
Всё ниже — blueprint. AgenKit — способ ship'ить это без ручного написания каждого слоя.
Эта статья — полный engineering manual.
К концу статьи вы будете знать:
- Как построить 24/7 HFT trading bot hedge-fund quality на самой быстрой decision model, доступной сейчас, Jev.
- Как разделить trading system на deterministic code и probabilistic judgment — разделение, которое реально работает.
- Как запускать полный набор parallel judgments на каждом block одним call, с latency одного вопроса.
- Полную настройку from scratch: от waitlist до первого typed decision за 10 минут.
- Что именно Jev заменяет в вашем stack, а что нет, достаточно точно, чтобы меня можно было за это спросить.
Поехали.
Part 1: что такое Jev и почему он подходит HFT
Jev — не LLM. Он не генерирует текст и не объясняет себя.
TypeSafe называет его System One model, по быстрой интуитивной системе мышления Канемана.
Ставка такая: большинство решений внутри software — это System 1 judgments: в какой bucket, срочно ли это, toxic ли это. А мы арендовали медленные System 2 chat models, чтобы принимать их.
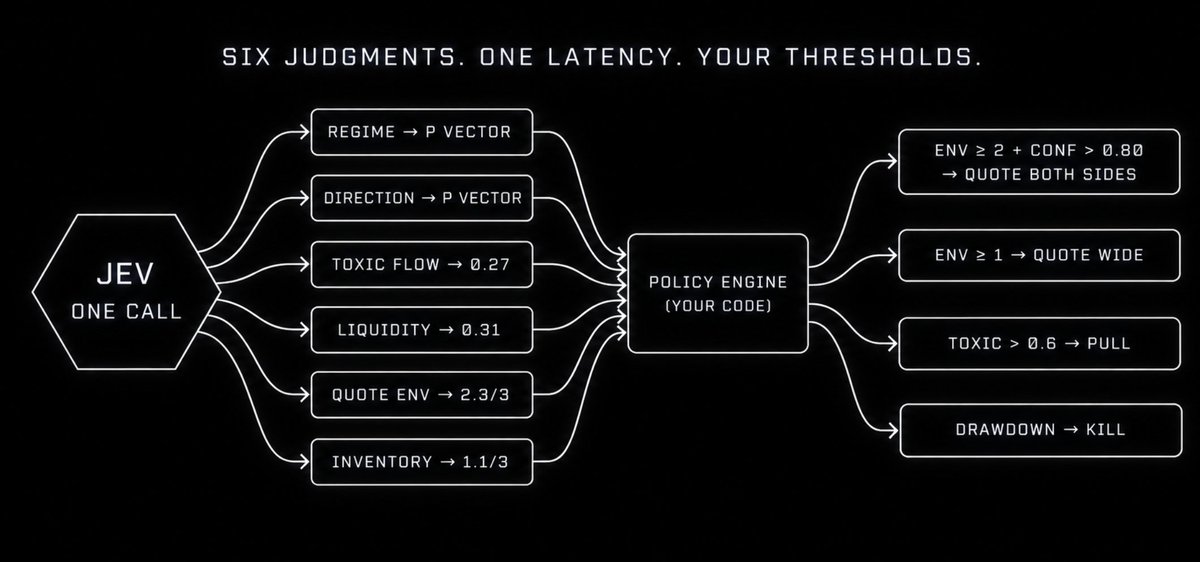
Понять Jev проще через этот visual:
Ментальная модель:
LLM: state → text. Jev: state → decision distribution.
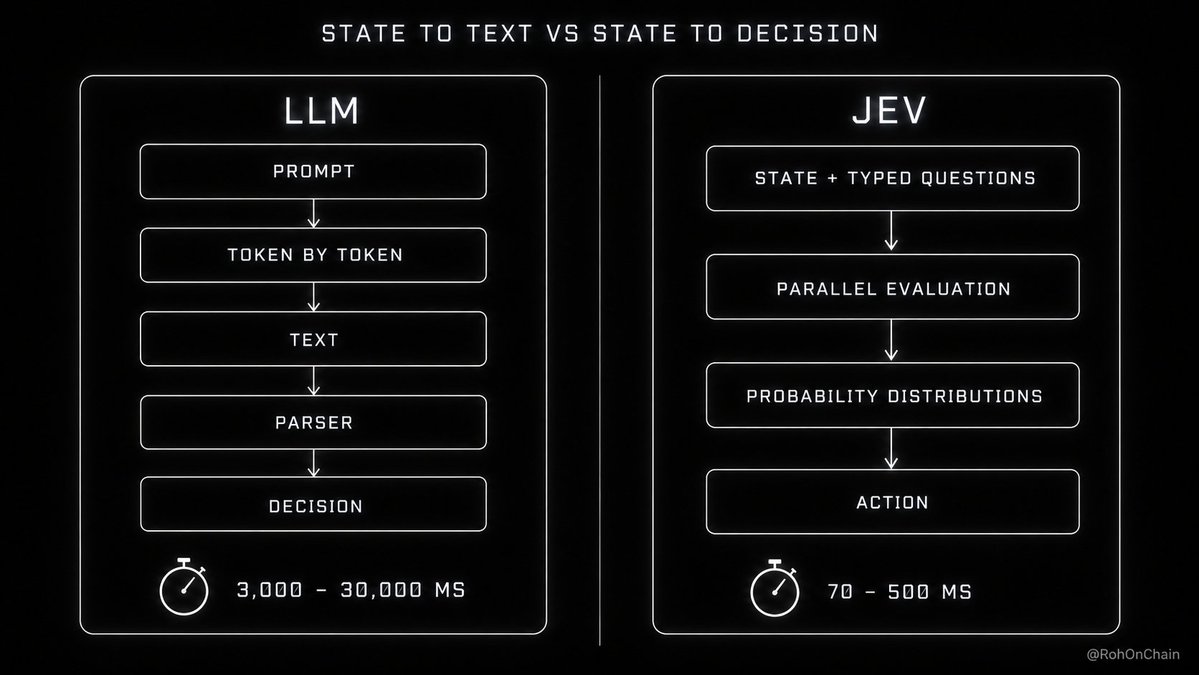
Вы отправляете state — любой JSON, например snapshot order book — плюс typed questions с заранее заданными answer spaces. Jev возвращает typed answers с probabilities и confidence. Без prose, без parsing, без JSON repair.
Три primitive прямо из docs.typesafe.ai:
- Noul возвращает значение от 0 до 1. Flow toxic? → 0.83
- Choice выбирает один вариант из списка, до 255. Какой regime? → trending 0.63, mean_reverting 0.22, chaotic 0.15
- Score оценивает state по вашей rubric. Quote environment от 0 до 3? → 2.3
Все три смешиваются в одном call. Каждый вопрос оценивается параллельно и изолированно. Добавление вопросов почти не двигает latency, и нет context rot, потому что каждый вопрос оценивается независимо.
Скорость объясняют два факта.
- Jev не autoregressive. LLM декодирует token за token последовательно. Jev считает probability distributions по всем choices параллельными проходами. Шесть вопросов дают latency одного.
- Jev обучен с RLCD, Reinforcement Learning for Calibrated Decisions. Он оптимизирует probabilities по реальным outcomes, а не по human preference. Более высокий confidence действительно означает более высокую accuracy в aggregate.
Context — 32 000 tokens. Этого хватает для dense snapshot и recent trades. Не для вашей strategy doc, и в этом смысл. Jev отвечает на узкие вопросы о compact state. Остальным владеет code.
Где Jev помещается в latency budget?
Colocated equities живут в microseconds. Jev туда не нужен. FPGA и C++ держат эту полосу.
On-chain order books работают в block cadence. Monad blocks каждые 300ms, Solana slots около 400ms. Jev помещается в один block с запасом на execution.
Tactical reads — regime, toxicity, strategy selection — имеют горизонты в секунды. По cost Jev идеален здесь.
Cost меняет architecture: один fully loaded decision каждый block, 24/7, стоит $10-25 в месяц. Тот же loop на frontier LLM стоит $50-150 в час.
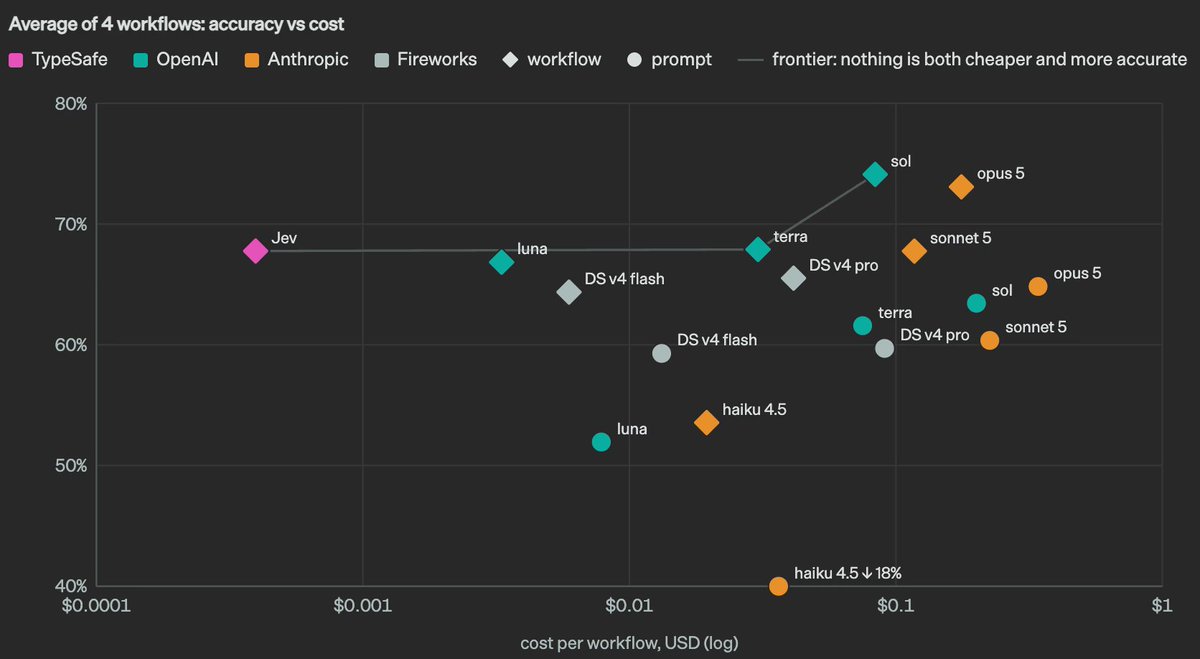
На собственном TypeSafe eval из четырёх workflows Jev показывает 67,8% agreement с frontier consensus при $0,0004 за case, против GPT-5.6 Terra с 67,9% и $0,0304. Та же accuracy, в 76 раз дешевле. Vendor numbers, directional, но направление не тонкое.
Part 2: архитектура, которая отделяет systems от demos
Один принцип держит всю сборку.
Jev не должен владеть trading system. Он должен владеть выбранными judgments внутри неё.
Каждый неудачный AI bot, который я видел, просил модель торговать: «Посмотри на BTC, скажи, что делать». На этот вопрос невозможно ответить при любой latency.
Правильное разложение:
Code считает state. Jev интерпретирует state. Code применяет policy. Execution размещает order.
Всё вычислимое остаётся в code: mid, spread, imbalance, realized vol, inventory, drawdown, VWAP, queue position. Никогда не тратьте Jev call на arithmetic. Это совпадает с методологией TypeSafe: deterministic facts в code, models для fuzzy judgment.
Всё, что является judgment, идёт в Jev: regime trending или mean-reverting? Flow informed или noise? Setup хороший? Execution ухудшился?
И official design rule для questions: atomic questions, composed in code. Если вопрос требует reasoning или взвешивает несколько факторов, разложите его. Спросите каждый factor отдельно, объедините своими weights. Когда priorities меняются, вы редактируете coefficient, а не prompt.
                MARKET DATA
                     ↓
              FEATURE ENGINE
                     ↓
         DETERMINISTIC STATE SNAPSHOT
                     ↓
                    JEV
          ┌──────────┼──────────┐
       REGIME     TOXICITY   DIRECTION
       QUALITY    LIQUIDITY  RISK STATE
          └──────────┼──────────┘
                     ↓
              PROBABILITY VECTOR
                     ↓
               POLICY ENGINE
                     ↓
          ┌──────────┴──────────┐
     HARD RISK RULES       TRADE SIGNAL
          └──────────┬──────────┘
                     ↓
                 EXECUTION
Hard risk layer всегда побеждает. Part 5 разбирает его.

Part 3: настройка Jev с нуля за 10 минут
Без cloned repos. С нуля, по official quickstart.
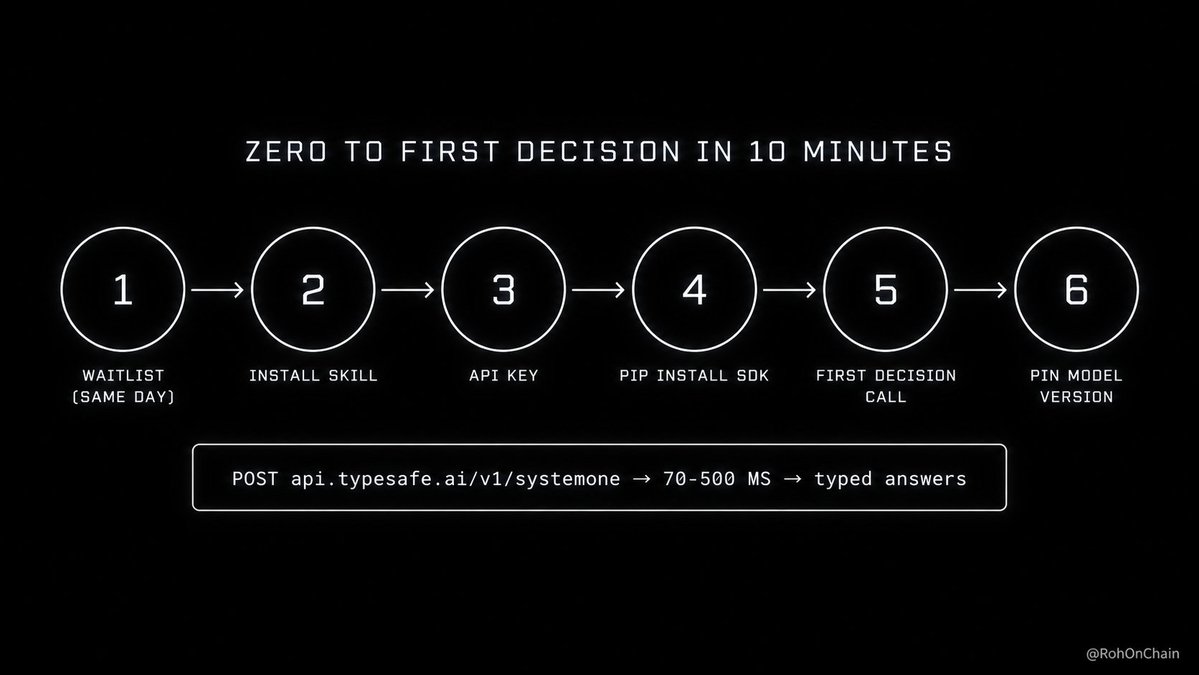
- Встаньте в waitlist. Подайте заявку на typesafe.ai. Людей одобряют в тот же день.
- Установите official skill, чтобы агент писал корректные Jev calls.
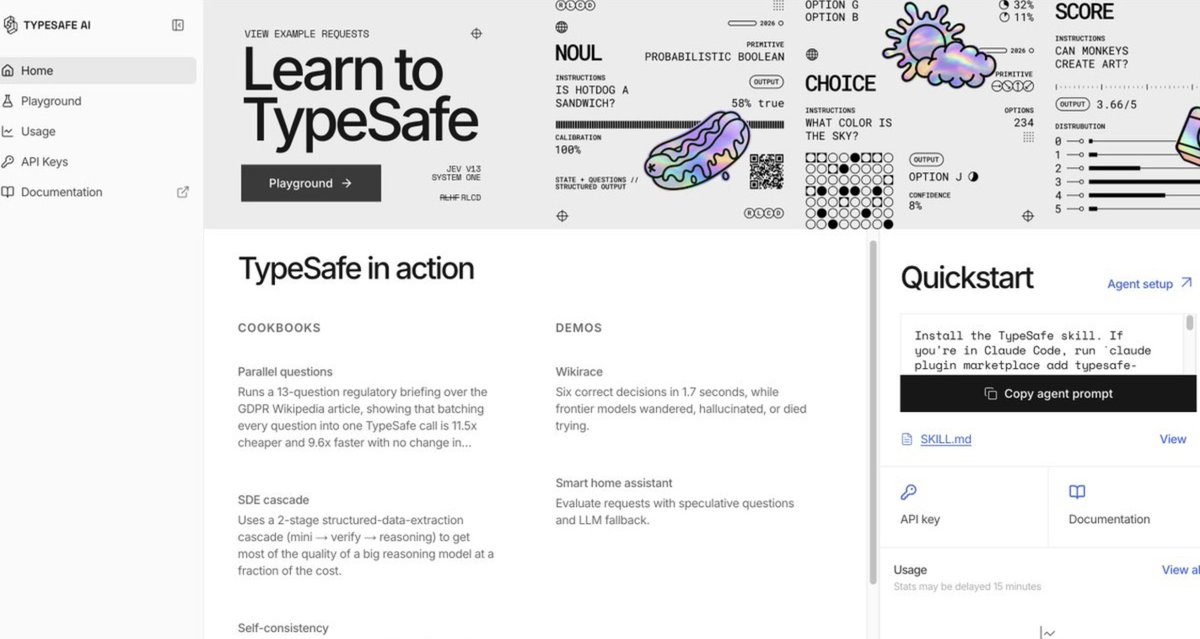
npx skills add typesafe-ai/skills --skill typesafe-aiНа Claude Code это две команды. Один marketplace add ничего не устанавливает.
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai- Создайте API key в dashboard.
export TYPESAFE_API_KEY="your-key"- Установите SDK. Для Python нужен 3.10+.
pip install typesafe-sdk        # Python
npm install @typesafe-ai/sdk    # TypeScript
cargo add typesafe-ai-rs        # Rust, for the execution layer
В agent достаточно одной фразы: скажите "use the TypeSafe skill" в prompt.
- Запустите первое decision. Client читает TYPESAFE_API_KEY и по умолчанию вызывает jev-latest.
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

state = {
    "mid": 3.4127, "spread_bps": 3.5, "imbalance": 0.71,
    "realized_vol_5m": 0.034, "inventory": -120,
    "aggressive_buy_ratio": 0.63
}

response = client.system_one(
    state=state,
    questions={
        "regime": Choice(
            instructions="What market regime does this state describe?",
            criteria={"trending": None, "mean_reverting": None, "chaotic": None},
        ),
        "toxic_flow": Noul(
            instructions="Is aggressive flow likely informed rather than noise?",
        ),
        "quote_environment": Score(
            instructions="How favorable is this state for providing liquidity?",
            legend={"0": "Do not quote", "1": "Marginal",
                    "2": "Standard", "3": "Excellent"},
        ),
    },
)
Две setup notes, которые спасут позже.
- Для HFT используйте direct API: POST https://api.typesafe.ai/v1/systemone. Gateways — OpenRouter как ~typesafe/jev-latest, Vercel AI Gateway как typesafe-ai/jev, LiteLLM passthrough — добавляют round trip, который нельзя вернуть.
- Pin your model version и логируйте version в каждом response. Ваши confidence gates калиброваны под одну модель. Silent upgrade с unpinned thresholds ломает systems тихо.
Part 4: state engine и parallel judgment battery
Два build steps, потому что они сердце системы.
State engine — чистый deterministic code, и именно здесь большинство builders недоинвестируют. На каждом block считайте compact snapshot до 400 tokens:
PRICE     mid, microprice, returns 1m/5m/30m
BOOK      spread bps, depth 3 levels, imbalance, queue position
FLOW      aggressive buy/sell volume, trade + cancel intensity
VOL       realized vol short + medium, vol vs 24h regime
CROSS     divergence vs reference venue, basis, funding
BOOK PnL  inventory, unrealized PnL, drawdown, position age
HEALTH    fill ratio, reject rate, slippage, last 10 latencies
Три правила. Держите snapshot dense и numeric: вы платите за input tokens. Timestamp discipline абсолютна: каждое поле использует только информацию строго до decision. Логируйте каждый snapshot вместе с decision — позже эта triple станет calibration data.
Judgment battery — место, где system побеждает demo. Один question — demo. Полная battery в одном call — professional pattern, и batching economics вознаграждает это 12x.
Именно так думают elite prop traders.
Не один buy/sell call, а battery одновременных reads.
response = client.system_one(
    state=snapshot,
    questions={
        "regime": Choice(instructions="Regime?",
            criteria={"trending": None, "mean_reverting": None,
                      "high_vol": None, "crisis": None}),
        "direction": Choice(instructions="Bias next 10 blocks?",
            criteria={"up": None, "down": None, "neutral": None}),
        "toxic_flow": Noul(instructions="Is aggressive flow informed?"),
        "liquidity_stressed": Noul(instructions="Book thinner than 24h norm?"),
        "quote_environment": Score(instructions="Favorable to provide liquidity?",
            legend={"0": "No", "1": "Marginal", "2": "Standard", "3": "Excellent"}),
        "inventory_pressure": Score(instructions="Urgency to cut inventory?",
            legend={"0": "None", "1": "Mild", "2": "Skew hard", "3": "Reduce now"}),
    },
)
Шесть judgments, один call, одна latency, около $0,00001 за block.
Затем policy engine, навсегда ваш в code:
def compose_action(ans, snap, limits):
    if snap["drawdown"] > limits.max_drawdown:        return KILL
    if ans["toxic_flow"].noul > 0.6:                  return PULL_QUOTES
    if ans["liquidity_stressed"].noul > 0.7:          return WIDEN

    q = ans["quote_environment"]
    if q.score >= 2.0 and q.confidence > 0.80:
        skew = inventory_skew(ans["inventory_pressure"].score)
        return quote_both_sides(skew=skew)
    if q.score >= 1.0:
        return quote_wide()
    return STAND_DOWN
Три пункта, которые нужно впитать.
Thresholds живут в вашем code, не в model, ровно как предписывают TypeSafe confidence docs.
Пишите отдельный threshold на каждое action, scaled to what being wrong costs, а не один на всю систему.
И fractional Kelly, (2p - 1) с cap на quarter, defendable только потому, что RLCD делает p meaningful. С LLM logprobs это fiction.
Part 5: 24/7 loop, risk engine и fallback ladder
Теперь собираем loop, который оправдывает 24/7.

Deterministic half market making — математика 50-летней давности, и она остаётся в code. Ваш pricing engine каждый block считает Avellaneda-Stoikov reservation price и spread:
reservation r = mid - inventory * gamma * sigma^2 * (T - t)
half spread   = gamma * sigma^2 * (T - t) + (2/gamma) * ln(1 + gamma/kappa)
Jev отвечает только на то, чего formula не может: стоит ли вообще quote'ить в эту environment?
Полный loop:
Block event (WebSocket newHeads + polling backstop)
  → read L2 book (best bid/ask/depth)
  → compute state snapshot (deterministic, < 400 tokens)
  → fire Jev battery (six judgments, one call)
  → policy engine composes action
  → A-S pricing computes reservation + spread
  → risk engine checks hard limits (absolute veto)
  → cancel old quotes, post new post-only orders
  → log, await fills, book PnL, update inventory
  → next block
Это девять stages, каждый — tested module со своими failure modes. Именно здесь hand-built system превращается в месяц debugging.
Направьте AgenKit на этот loop spec, и он ship'ит каждый layer с test-first discipline, от spec к review и deploy, так что к выходным вы calibrate'ите working system, а не всё ещё проводите WebSocket.
Две детали решают, переживёт ли это reality.
- Block deadline rule: если Jev decision не вернулся до следующего block, hold. Никогда не выставляйте quote на stale state. jev-trader обрабатывает именно этот случай.
- Gas honesty check: fork jevons critique посчитал и показал, что наивный every-block cancel-replace структурно теряет деньги, примерно 428 MON в час на gas против 3.5 bps spread. Вашему loop нужен wider spread, longer resting times или real directional edge из battery. Посчитайте это до первого live order.
Risk engine никогда не делегирует Jev. Hard-coded deterministic vetoes, проверяемые перед каждым order, zero negotiation:
max position   max daily loss    max drawdown
max order size max inventory age max stale-data age
max leverage   max API errors    max decision latency
Каждый limit должен проверяться чем-то, кроме собственного утверждения модели. File exists at path X. Metric below Y in the output. Никогда не верьте системе, которая просто говорит, что она ran.
Fallback ladder — причина, почему большинство «24/7» ботов на самом деле 24/7-until-2AM bots:
healthy + high confidence  → normal operation
healthy + low confidence   → reduce size or observe
late past block deadline   → hold, no stale quotes
Jev unavailable            → deterministic fallback only
hard limit breached        → kill switch, flatten, alert
С этой ladder система autonomous. Без неё она AI-powered до первого network partition.
Где retail реально может запускать это сегодня: on-chain order books с block cadence — Monad через Kuru, Solana DEXs, Hyperliquid — и prediction markets со spreads 200-500 bps. Что закрыто: top US equities, занятые Citadel Securities и Jane Street на microsecond speed. Не приносите 300ms loop на microsecond fight.
Part 6: calibration и honest contract
Calibration first, потому что именно этот шаг заставляет quants доверять системе.
Не backtest'ите «предсказал ли Jev price». Тестируйте whole policy.
Четыре baselines на одинаковых data, features, costs и limits: hand-written rules, frontier LLM layer, Jev layer и Jev plus confidence gating. Измеряйте Sharpe, Sortino, max drawdown, hit rate, slippage, adverse selection, cost per million decisions и coverage.
Сравнение Jev-plus-gating против plain-Jev — реальный research question: улучшает ли book отказ от действия при uncertainty? На calibrated model должен. В этом вся ставка.
Затем проверьте саму calibration.
Если Jev говорит P(up) = 0.80, происходят ли 80%-tagged events в 80% случаев на вашей venue? Постройте predicted probability против empirical frequency, посчитайте Brier score, log loss и Expected Calibration Error из ваших logged triples. RLCD calibrates against TypeSafe distribution, не против вашей. Если reliability curve изгибается, примените Platt scaling в policy layer.
Honest contract. Сделайте screenshot.
Jev МОЖЕТ: возвращать typed calibrated decisions за 70-500ms, оценивать десятки parallel questions с latency одного вопроса, обрабатывать 255 choices и 32K state, сидеть внутри 300ms block loop, заменять fuzzy rules, LLM classification, heuristic scoring, regime classifiers и guardrails, управлять fractional Kelly после проверки calibration и запускать full battery каждый block за $10-25 в месяц.
Jev НЕ МОЖЕТ: генерировать текст или проектировать вашу strategy, chain dependent judgments in one call (questions isolated, dependencies — second request), конкурировать в microsecond lane, заменять market data infra, numerical computation, exchange connectivity или hard risk controls, гарантировать vendor numbers на вашем workload или превращать losing strategy в winning one. Jev делает decisions дешёвыми и быстрыми. Edge всё ещё ваша работа.
Второй список — не hedging. Именно он делает первый список believable.
Closing
Jev — не более умная LLM.
Это другой вид: decision engine, который возвращает calibrated probabilities в budget одного block.
Побеждает не система, которая просит Jev торговать. Побеждает та, что считает всё вычислимое в code, отправляет один compact state с full battery atomic questions, gates every action on calibrated confidence, prices with deterministic math и держит hard risk rules с absolute veto power.
Я использовал Jev не потому, что это newest model on the timeline.
Я разложил trading system на deterministic computation и probabilistic judgment, затем проверил, подходит ли calibrated decision model ко второй половине.
Пока ответ — да, и logs, которые это доказывают, всё равно являются calibration data, нужной системе.
В прошлых статьях я разбирал mathematical trading models на GPT-6 Astra, one-person hedge fund architecture и market making layer. Эта добавляет millisecond judgment engine между state и order.
И вот вопрос.
Вы всё ещё отправляете order book в chat model и ждёте 8 секунд prose, или задаёте 6 typed questions и получаете 6 calibrated answers до прихода следующего block?
Неправильного ответа нет. Но некоторые ответы многое показывают.