
Jev Engineering: как собрать самый быстрый мозг AI-агента за 10 шагов (полная настройка)
Полный русский перевод X Article о Jev Engineering: как вынести решения из дорогого LLM-цикла в быстрый System One слой.

Источник: https://x.com/0xMovez/status/2101007482919227841
Автор: Movez
У каждого агента, которого вы строили, одна и та же проблема. LLM стоимостью $0,03 за вызов сидит в цикле: отвечает на вопросы «да/нет», выбирает следующего воркера и оценивает релевантность.
Для таких решений не нужна генерация. Нужна модель, которая создана именно для принятия решений.
Это настройка из 10 шагов, которая даёт вашим агентам отдельный decision brain. Установите один раз. Измерьте. Затем замените каждую дорогую развилку.

Парадокс Джевонса — правило из 1865 года: когда паровая машина эффективнее расходует уголь, общее потребление угля растёт, а не падает.
Подпишитесь на мой Substack, чтобы получать свежую AI-альфу: movez.substack.com
Это глобальная проблема AI. Токены дешевеют каждый квартал. Использование взрывается. Счёт остаётся тем же или растёт. Jev от @typesafeai создан, чтобы разорвать этот цикл.

Это модель System One: вы отправляете ей состояние и заранее заданные вопросы, она возвращает типизированные ответы с вероятностями. Без генерации текста. Без чата. Без авторегрессионного цикла.
Она делает одну вещь. Принимает решения. И делает это в 200 раз быстрее и в 400 раз дешевле, чем LLM для той же задачи.
01. Разделение — ищите решения, а не текст
Jev — System One модель TypeSafe AI. Вы передаёте информацию и заранее заданные вопросы. Она возвращает типизированные ответы с вероятностями. Она не может написать ваш брифинг, сгенерировать код или объяснить ход рассуждений прозой.
Начните с такой задачи:
Research three new AI-agent tools and draft tomorrow's briefing. Save
the draft for my review.
В этой задаче есть несколько решений: достаточно ли источников? Какой воркер должен идти следующим? Готов ли черновик к ревью?
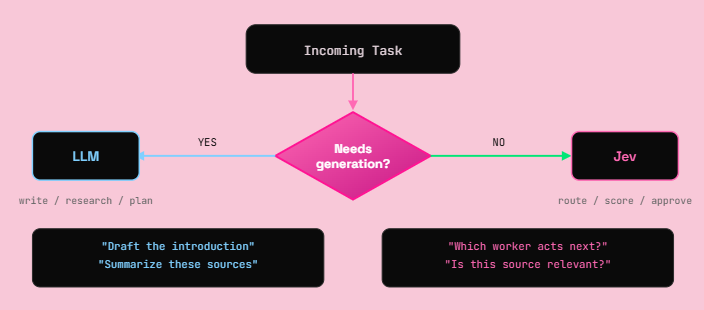
Это кандидаты для Jev. Поиск источников, написание абзацев и сохранение файлов по-прежнему относятся к вашим инструментам и генеративным моделям. Точное правило, например остановиться после десяти действий, должно жить в коде.
Разделение простое. Если операция создаёт текст, она остаётся у LLM. Если операция выбирает вариант из списка, выставляет оценку или отвечает да/нет, она уходит в Jev.
02. Playground — проверьте один вопрос до кода
Откройте TypeSafe Playground. Войдите и пройдите процесс доступа, если он требуется вашему аккаунту.
Используйте это как состояние и добавьте вопрос: «Какой воркер должен действовать следующим?»
{
  "goal": "Compare three AI-agent tools in a morning briefing.",
  "completed_work": "No sources collected yet.",
  "available_workers": ["Researcher", "Writer"],
  "constraint": "Save drafts for review. Do not publish."
}
Задайте три варианта:
- research — если не хватает доказательств,
- write — если доказательств достаточно для черновика,
- review — если запрос неясен или работа завершена.

Запустите. Затем замените поле completed_work на реальные исследовательские заметки и сравните решение. Это базовое взаимодействие описано в официальном Quickstart.
03. SDK — установите и подключите API
Нужен аккаунт TypeSafe с включённым API-доступом и ключ из настроек ключей. API-вызовы списываются с этого аккаунта.
Установите Python 3.12 или новее, затем откройте Terminal.
$ mkdir jev-starter
$ cd jev-starter
$ python3 -m venv .venv
$ .venv/bin/python -m pip install --upgrade typesafe-sdk
> mkdir jev-starter
> cd jev-starter
> py -3 -m venv .venv
> .\.venv\Scripts\python.exe -m pip install --upgrade typesafe-sdk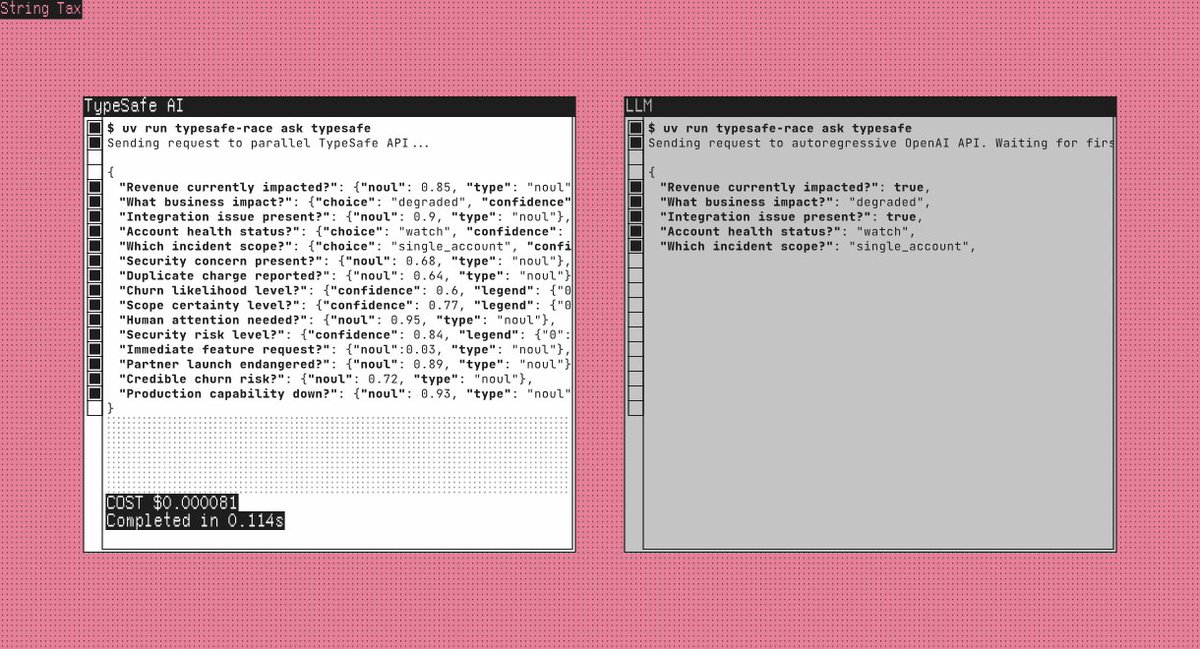
Если установлен Node.js/npm, добавьте официальный skill TypeSafe:
npx skills add typesafe-ai/skills --skill typesafe-ai
Выберите поддерживаемого агента, когда появится запрос. Skill даст ему инструкции по интеграции. Сам Jev работает через API.
04. Handoff — сохраняйте решения как локальные JSON-очереди
Создайте chief.py внутри jev-starter, но вне .venv. Это автономный маршрутизатор решений: введите задачу, дайте Jev выбрать направление, сохраните handoff на компьютере.
import json
import os
from getpass import getpass
from pathlib import Path
from uuid import uuid4
from typesafe_sdk import Choice, TypeSafeAPIError, TypeSafeClient

if not os.environ.get("TYPESAFE_API_KEY"):
    os.environ["TYPESAFE_API_KEY"] = getpass("TypeSafe API key: ").strip()

goal = input("Goal: ").strip()
if not goal:
    raise SystemExit("Enter a goal.")
notes = input("Completed work: ").strip() or "Nothing yet."
state = {"goal": goal, "completed_work": notes}

try:
    with TypeSafeClient(model="jev-1.13.0") as client:
        result = client.system_one(
            state=state,
            questions={
                "next_worker": Choice(
                    instructions="Choose the next step for a research briefing.",
                    criteria={
                        "research": "Collect evidence still needed for the goal.",
                        "write": "Draft the briefing from sufficient evidence.",
                        "review": "Goal unclear, outside scope, or work complete.",
                    },
                )
            },
        )
except TypeSafeAPIError as error:
    raise SystemExit(f"API error {error.status}; see Step 8.")

answer = result.choices["next_worker"]
destination = "review"
if answer.choice in {"research", "write"} and answer.confidence >= 0.85:
    destination = answer.choice

folder = Path(__file__).resolve().parent / "queue" / destination
folder.mkdir(parents=True, exist_ok=True)
job = folder / f"{uuid4().hex}.json"
payload = dict(state, choice=answer.choice, confidence=answer.confidence,
               destination=destination, status="queued")
job.write_text(json.dumps(payload, indent=2, ensure_ascii=False), encoding="utf-8")
print("Saved handoff:", job)
$ .venv/bin/python chief.py
TypeSafe API key: ••••••••••
Goal: Compare three AI-agent tools for tomorrow's briefing
Completed work: No sources collected yet
Saved handoff: /Users/you/jev-starter/queue/research/a3f8...jsonОткройте этот JSON-файл. В нём есть ваш запрос, прогресс, выбор Jev, confidence и направление. Каждый запуск создаёт новый файл в queue/research, queue/write или queue/review.
Это локальные очереди задач. Сохранённая задача ждёт, пока её заберёт воркер.
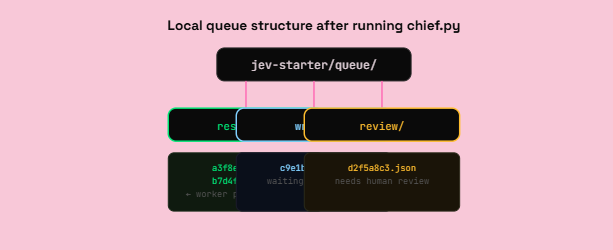
Порог confidence установлен на 0,85. Настраивайте его на размеченных примерах из вашего workflow. Confidence — это не процент точности.
05. Questions — Choice, Score и Noul
Jev даёт три типа вопросов, каждый под свой тип решения:

Полезная деталь: Jev не видит ID вашего вопроса. Название поля safe_to_publish не добавляет инструкций. Формулируйте настоящее требование в самом вопросе и ясно описывайте каждый вариант.
Также передавайте evidence. Фраза «исследователь закончил» говорит Jev меньше, чем источники, находки и оставшиеся пробелы. Держите эти поля отдельно от исходного запроса.
System One модели оценивают все вопросы в запросе параллельно. Добавление вопросов почти не меняет время ответа и стоит только токенов на дополнительный вопрос.
06. Dynamic Menu — пересобирайте варианты каждый ход
Доступные действия браузера меняются после каждого клика. Browser Use строит свежий список видимых контролов и даёт Jev выбрать из него. Небольшая LLM генерирует текст только тогда, когда нужно заполнить поле ввода.
Примените этот дизайн к вашему Chief of Staff. Собирайте варианты из воркеров, которые существуют и доступны прямо сейчас. Указывайте текущие source IDs при выборе исследовательского материала.

Обновляйте варианты после того, как инструмент изменил состояние. Иначе ваша decision model выбирает из вчерашнего меню.
07. Parallel — объединяйте вопросы в один вызов
Вашему диспетчеру может понадобиться выбрать воркера, оценить срочность и проверить разрешение. Если все три вопроса могут смотреть на одно состояние, отправляйте их вместе.
TypeSafe поддерживает параллельные вопросы и speculative branches: спросите о возможных следующих действиях, затем используйте только тот ответ, который относится к выбранной ветке.
Вопросы не могут читать ответы друг друга. Если решению нужен свежий результат поиска, сначала выполните поиск.
result = client.system_one(
    state=state,
    questions={
        "next_worker": Choice(
            instructions="Choose the next step.",
            criteria={...}
        ),
        "urgency": Score(
            instructions="Rate request urgency.",
            labels=["low", "medium", "high", "critical"]
        ),
        "safe_to_run": Noul(
            instructions="The requested action is safe to execute without human review."
        ),
    },
)
Пример Browser Use показывает ещё одно узкое место. Его оптимизированный runtime снизил медианное число browser protocol calls с 1 092 до 101, а медианное время задачи упало на 25% на трёх сопоставленных парах. В обеих версиях использовались одни и те же модели.
Изменения включали сбор состояния страницы за одно чтение и отказ от свежих предсказаний для нерелевантных анимаций. Проверьте повторяющиеся tool calls, прежде чем платить за более быструю модель.
08. Guardrails — задайте лимиты и условия остановки
Для утреннего брифинга разрешите сбор источников и создание черновика, затем останавливайтесь на review. Публикация должна требовать отдельной проверки разрешения.
Приложению также нужны лимит действий, лимит расходов и сохранённый прогресс. После прерывания оно должно проверять последнее завершённое действие, прежде чем повторять что-либо. Уверенный ответ не доказывает, что файл был сохранён или сообщение отправлено.
Browser Use независимо проверяет результат после того, как Jev выбирает DONE. Возьмите это разделение для собственных completion checks.
AGENT HANDOFF BRIEF

Read the TypeSafe skill and inspect my worker interfaces. Connect
chief.py's JSON queues to existing research and writing handlers.

Prevent duplicate processing. Save progress after each action. Add
call and spending limits, review on uncertainty, and a draft-exists
completion check. Keep publishing behind approval. Identify missing
connectors explicitly.
Если starter падает, используйте ошибку, чтобы выбрать исправление:

DEEP DIVE // JEV HARNESS
Агенты работают в цикле: LLM решает, что делать, инструмент выполняет, модель оценивает результат, и цикл продолжается до завершения задачи. Два примитива упростили это: tool calling для структурированных запросов и structured outputs для структурированных результатов.
Но даже с ними каждое решение в этом цикле всё ещё стоит полноценного model call.
Именно здесь harness важнее модели.
Harness — это разница между 78% и 42% на одной и той же модели. Те же веса. Другая инженерия цикла. Harness определяет производительность.
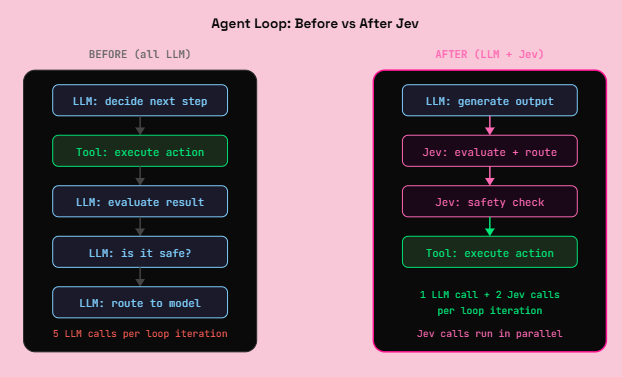
Coding harnesses вроде Claude Code, Codex и Cursor уже поставили какой-то способ классифицировать опасные действия до их выполнения.
Этот classifier step постепенно помогал строить доверие к агентам. До сих пор он был заперт в закрытых частях harness.
Теперь, когда появилась дешёвая и производительная classifier model, вы можете взять тот же паттерн и применить его ко всем агентам.
Та же модель. Те же инструменты. Другой harness. Другие результаты.
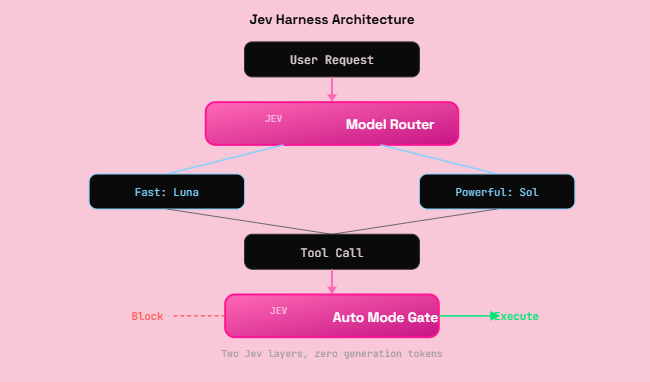
LangChain AutoModeMiddleware использует Jev, чтобы проверять каждый tool call на рискованные решения до выполнения инструмента. Одна строка middleware. Ноль generation tokens на safety checks.
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import (
    AutoModeMiddleware,
)

# Jev checks every tool call before execution
# Blocks risky actions, approves safe ones
guardrail = AutoModeMiddleware(tools=["bash"])

agent = create_agent("openai:gpt-5.6-luna", middleware=[guardrail])
Harness даёт два слоя Jev. Model router наверху выбирает самую дешёвую модель, которая справится с запросом. Auto Mode gate внизу блокирует опасные tool calls до их выполнения.
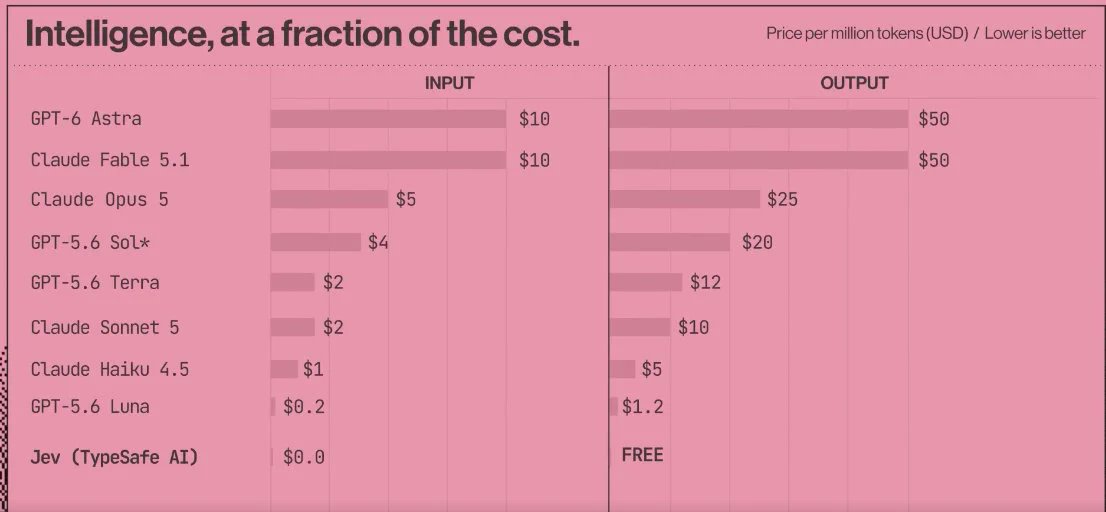
Ни один слой не генерирует текст. Ни один слой не добавляет задержку, которую вы почувствуете. Оба работают по той же цене $0,042 за миллион.
09. Cost — что покупают $0,042 за миллион
Jev 1.13 стоит $0,042 за миллион входных токенов без платы за output tokens. При 1 000 тарифицируемых входных токенов на решение 10 000 решений стоят $0,42 за inference Jev.
Заявленные $0,0039 в flight demo соответствуют записанным 90 558 входным токенам Jev плюс указанной стоимости text helper. Стоимость браузера не входит в этот расчёт. Примерно семисекундный таймер стартует после начального наблюдения страницы и исключает свежую post-run verification.
Он находит авиарейсы. Он не бронирует билеты.
Для другого workload команда Vercel fx сообщала примерно о 5-18x более быстрой safety classification по сравнению с GPT-5.6-Luna, вместе с улучшенной точностью.
Это сравнение касается classifier, а не длительности всего agent run.
Отслеживайте счёт за завершённую задачу. Дешёвое решение, которое отправляет воркера в неправильную ветку, может стоить дороже самого решения.
10. Deploy — пять production-сценариев
После базовой настройки Jev уже может читать состояние задачи и выбирать между заранее заданными вариантами. Теперь нужно решить, какое повторяющееся решение автоматизировать.
- Control a Browser
Browser Use использовал Jev, чтобы выбирать следующее действие и правильный элемент страницы. Агент нашёл рейсы за 7 секунд за $0,0039.
Как повторить:
Запустите официальный проект Browser Use, добавьте ключи TypeSafe и OpenRouter, затем дайте агенту сайт и цель. Jev выбирает действие и цель. Браузер выполняет решение.
- Classify Research:
Hassan использовал Jev, чтобы классифицировать 1 018 AI research papers. Вся классификация стоила $0,08, медианная end-to-end latency на одну статью составила 256 мс.
Как повторить:
Отправьте в Jev название и summary каждой статьи, затем задайте ваши темы как Choice options. Сохраните выбранную категорию и отправьте самые сильные статьи writing agent.
- Triage Your Inbox:
Riley Brown показал, как Jev может классифицировать входящие письма и решать, что делать дальше. 500 писем классифицированы за 3,5 цента.
Как повторить:
Передавайте каждое письмо как state, затем добавьте reply, research, wait и review как Choice options. Подключите каждый ответ к соответствующей папке или email agent.
- Route Tasks Between Models:
LangChain использует Jev, чтобы выбирать между более дешёвыми и более мощными моделями в зависимости от задачи. Простые задачи идут к быстрой модели. Сложные — к reasoning model.
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import (
    ModelChoice, ModelRouterMiddleware,
)

router = ModelRouterMiddleware(
    choices={
        "fast": ModelChoice(
            model="openai:luna",
            criteria="Direct lookups, extraction, localized changes.",
        ),
        "powerful": ModelChoice(
            model="openai:sol",
            criteria="Architecture and high-stakes decisions.",
        ),
    },
    instructions="Choose the least costly model that can complete the task.",
)

agent = create_agent("openai:gpt-5.6-luna", middleware=[router])- Instant Context Compaction
Tamara нашла идеальный use case: instant compaction. В 2026 году почему compaction всё ещё выглядит как summarization prompt? Jev может сделать его мгновенным, оценивая каждый tool call и отбрасывая нерелевантное.
Alex Volkov проверил это: 1 секунда на сжатие Claude session почти с 1M токенов до 86K. Это не summarization pass. Это relevance filter на скорости Jev.
Conclusion:
Jev — не очередной chatbot. Это быстрый decision layer, который читает текущее состояние вашей системы и выбирает между заданными вами вариантами.
И настоящая альфа — не семисекундная flight demo и не классификация papers за $0,08.
Настоящая альфа — понять, сколько дорогих LLM calls внутри ваших агентов никогда не нуждались в генерации:
Пусть LLM исследует, планирует и пишет. Пусть Jev маршрутизирует, оценивает, одобряет или эскалирует. Пусть код выполняет решение.
Это разделение меняет весь agent stack.
Теперь у вас есть настройка, рабочий decision router и четыре реальных способа задеплоить это. Начните с одного повторяющегося решения. Измерьте. Затем замените следующее.
Большинство builders продолжат тратить frontier-model токены на каждое yes, no, route и score.
Те немногие, кто отделит thinking от deciding, будут строить более быстрых агентов за долю стоимости.
Сохраните это перед следующей сборкой агента.