
Jev: понятное объяснение
Jev — не ещё один чат-бот, а семантический механизм для быстрых типизированных решений там, где пространство ответов заранее известно.
Оригинал опубликован Akshay 🚀 в X. Перевод полной X Article.
Мы используем LLM как молоток для любой AI-задачи, даже для простых решений. Jev обрабатывает такие решения за миллисекунды и за долю стоимости. Разберёмся, как он работает и где ему место.
TypeSafe AI выпустила Jev 15 сентября 2026 года, и реакция оказалась необычно сильной для модели, которая не умеет вести беседу, писать код или генерировать хотя бы один полезный абзац.
Но именно в этом ограничении и смысл.
Большинству программ не нужен ещё один чат-бот. Им нужно принимать тысячи небольших суждений: срочный ли это тикет? Какая модель должна обработать запрос? Опасна ли эта shell-команда? Отвечает ли найденный фрагмент на вопрос?
Команды часто отправляют каждое такое суждение в LLM общего назначения. Модель генерирует ответ токен за токеном, приложение парсит его, валидирует и повторяет попытку, если форма ответа не та. Это работает, но медленно и дорого для решения с пятью возможными вариантами.
Jev построен специально для таких решений. TypeSafe называет его моделью System One: на вход поступает неструктурированное состояние, на выходе — типизированные ответы и вероятности.
Разберём, что это значит, где это применимо и где маркетингу стоит чуть умерить тон.

Сначала — проблема, которую решает Jev
LLM стало гораздо проще подключать к программам после появления tool calling и structured outputs.
Tool calling позволяет модели запросить функцию в предсказуемой форме. Structured outputs позволяют вернуть JSON, который следует схеме. Оба подхода убрали много хрупкого парсинга.
Но базовая модель всё ещё остаётся генеративной. Даже когда ответ — одно слово «billing», она производит токены последовательно. Вы платите за вход, ждёте генерацию и часто ещё платите за выход.
Теперь поместите это внутрь agent loop.
while not done:
    action = llm(context)
    result = run_tool(action)
    context += result
Модель могут вызывать снова, чтобы выбрать инструмент, оценить результат, обнаружить риск, решить, завершена ли задача, и выбрать следующую модель. Один запуск агента может содержать множество вызовов, где требуется суждение, но не нужен сгенерированный текст.
Jev нацелен именно на эти вызовы.
Его ставка проста: генерация языка — неправильный интерфейс, когда код уже знает возможные ответы.
Что такое Jev на самом деле
Самое короткое точное описание: семантический механизм принятия решений.
Вы отправляете Jev две вещи:
- State: текст или JSON, описывающий текущую ситуацию.
- Questions: решения, которые нужно принять по этому состоянию.
Каждый вопрос заранее объявляет форму ответа. Jev поддерживает три примитива:
- Choice выбирает один вариант из заданного списка и возвращает вероятность для каждого варианта.
- Score помещает вход на заданную упорядоченную шкалу, например low, medium и high.
- Noul отвечает на вопрос «да/нет», возвращая вероятность того, что утверждение истинно.
Noul — название TypeSafe для Boolean-подобного примитива. Само странное имя менее важно, чем выход: число от 0 до 1, на которое ваш код может реагировать.
{
  "model": "jev-latest",
  "state": "The deploy failed twice and customers are seeing 500s.",
  "questions": {
    "urgent": {
      "type": "noul",
      "instructions": "Does this need attention right now?"
    },
    "owner": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "engineering": "Product failures and outages",
        "billing": "Charges, invoices, and refunds",
        "sales": "Pricing and new accounts"
      }
    }
  }
}
Ответ содержит вероятность срочности и распределение вероятностей по трём командам. Здесь нет абзаца, который нужно интерпретировать, и нет четвёртой команды, которую модель могла бы выдумать.
Ваша программа сохраняет контроль:
if urgent > 0.9 and owner == "engineering":
    page_on_call()
elif confidence < 0.6:
    send_to_human_review()
else:
    add_to_queue(owner)
Поэтому Jev часто называют «умным switch statement». Звучит пренебрежительно, но хорошо схватывает полезную часть дизайна. Обычный код владеет ветками. Модель добавляет нечёткое суждение, которое обычный код надёжно посчитать не может.

Важное отличие от LLM
Традиционная LLM и Jev обе могут классифицировать support ticket. Но они приходят к ответу по-разному и полезны в разных частях системы.

TypeSafe говорит, что Jev оценивает все вопросы в одном запросе параллельно. Это меняет дизайн workflow. Вместо того чтобы задать один вопрос, дождаться ответа и решить, какой вопрос задать дальше, можно задать все независимые вопросы об одном и том же состоянии за один запрос, а затем дать коду использовать нужные ответы.
Компания заявляет end-to-end latency от 70 до 500 миллисекунд и цену $0,042 за миллион входных токенов, при бесплатном выходе. В заголовочных заявлениях это доходит примерно до 200 раз быстрее и 400 раз дешевле сопоставимых LLM workflow.
Такие большие множители получены из собственных workflow-оценок TypeSafe и находятся на благоприятном краю сравнения. Их стоит считать потолком, а не обещанием для любого приложения. Но базовое преимущество выглядит правдоподобно: Jev избегает длинных reasoning traces и генерации выходного текста, потому что он спроектирован для ограниченных решений.

Почему вероятности важны
Типизированный ответ решает только половину проблемы.
Предположим, Jev маршрутизирует тикет в billing. Выбранная метка говорит, кто победил. Распределение вероятностей говорит, насколько близкой была гонка.
{
  "choice": "billing",
  "probabilities": {
    "billing": 0.52,
    "technical": 0.46,
    "sales": 0.02
  },
  "confidence": 0.18
}
Автоматически маршрутизировать такой тикет было бы неосторожно. Billing победил, но с минимальным отрывом. Низкая уверенность должна запускать другую ветку.
Это даёт разработчикам практический паттерн:
- Высокая уверенность: действовать автоматически, если последствия невелики.
- Средняя уверенность: запросить подтверждение или вызвать более сильную модель.
- Низкая уверенность: отправить кейс человеку или собрать больше информации.
Пороги должны жить в коде, где их можно ревьюить и менять. Метка на dashboard может терпеть слабое предсказание. Команда, удаляющая данные, должна требовать гораздо более высокой планки.
TypeSafe обучает Jev с помощью Reinforcement Learning for Calibrated Decisions, или RLCD. Цель — чтобы confidence отражала accuracy на множестве предсказаний. Если модель даёт набору ответов вероятность 90%, примерно 90% этих ответов должны быть правильными.
Утверждение про hallucination требует точности
TypeSafe говорит, что Jev не может hallucinate. Это верно только в узком смысле.
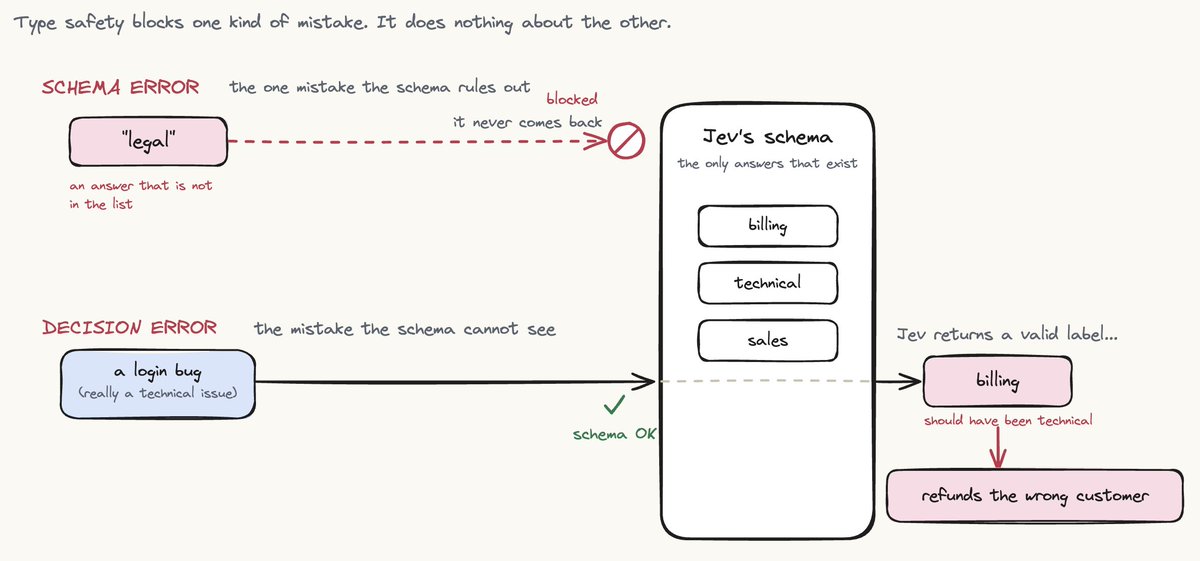
Jev не может вернуть вариант вне схемы. Если вы задали billing, technical и sales, ответ не сможет выдумать legal. Он также не сможет выдать malformed prose там, где код ожидал label.
Но он может уверенно выбрать неправильный допустимый вариант.
Type safety предотвращает неверную форму. Она не гарантирует правильное суждение. Это различие важно, потому что schema-valid ошибка всё ещё может вернуть деньги не тому клиенту, неправильно маршрутизировать инцидент или одобрить опасную команду.
Более безопасная формулировка: «Jev не может нарушить объявленную output schema, но всё равно может ошибаться».
Где Jev вписывается в агента
Jev лучше всего работает, когда используется вместе с LLM, а не вместо неё.
LLM берёт на себя работу, где нужен язык или более глубокое рассуждение. Она планирует, пишет, объясняет и использует инструменты. Jev обрабатывает частые решения вокруг этой работы.
Три места особенно убедительны.
Маршрутизация моделей
Простой lookup не требует той же модели, что архитектурное ревью. Jev может оценить запрос и выбрать наименее дорогую модель, которая с высокой вероятностью справится.
route = jev.choice(
    state=user_request,
    options={
        "fast": "Lookups, extraction, and small local edits",
        "powerful": "Architecture, ambiguity, and high-stakes work",
    },
)

model = fast_model if route == "fast" else powerful_model
Router не отвечает на запрос. Он решает, какая модель должна отвечать.
Проверка риска инструментов
Перед тем как агент выполнит shell-команду, Jev может классифицировать её как read-only, reversible или destructive. Отдельные вопросы могут проверить, удаляет ли она файлы, меняет ли историю Git, трогает ли production или выходит ли за пределы репозитория.
Read-only действия с высокой уверенностью могут продолжаться. Destructive или uncertain действия могут останавливаться для человеческого approval. LangChain-интеграция Jev применяет этот паттерн через middleware, который проверяет tool call перед выполнением.
Верификация и supervision
Агент может заявить, что задача завершена, хотя тесты всё ещё падают. Jev может inspect state и ответить на ограниченные вопросы: прошли ли тесты? Повторяет ли агент одно и то же действие? Соответствует ли результат policy? Нужно ли отправить результат на review?
Он не заменит жёсткий тест там, где такой тест существует. Он добавляет семантическую проверку там, где правило зависит от смысла.

Задачи, которые Jev может решать уже сегодня
Лучшие use cases имеют три общих свойства. Вы можете назвать возможные ответы, внимательный человек мог бы быстро оценить вход, и решение происходит достаточно часто, чтобы latency или cost имели значение.
Support и operations
- Классифицировать intent, urgency, department, spam и customer frustration.
- Маршрутизировать refunds и policy exceptions через несколько маленьких проверок.
- Ранжировать logs и incidents по семантической severity до того, как их прочитает человек.
Один запрос может задать все эти вопросы об одном тикете. Затем код объединяет ответы в фактическую routing policy компании.
Search и retrieval
- Rerank найденные passages по тому, отвечают ли они на query.
- Проверять, поддерживает ли citation конкретный claim.
- Фильтровать нерелевантные chunks перед отправкой контекста в дорогую LLM.
Embeddings отлично находят семантически связанные тексты. Jev может принять более узкое решение: полезен ли конкретный passage для этого вопроса.
Quality и safety
- Проверять prompts на jailbreaks или prompt injection.
- Сверять generated content с policy или rubric.
- Флагать рискованные code changes или tool calls до выполнения.
Такие проверки должны стоять рядом с deterministic controls. Semantic classifier полезен для fuzzy risk, а permissions, sandboxes и tests обеспечивают правила, которые software может проверить точно.
Массовая классификация
- Размечать documents, research papers, product listings или customer messages.
- Превращать free text в features для традиционной ML-модели.
- Оценивать каждый item в большом corpus по одной rubric.
Здесь низкая per-call cost становится чем-то большим, чем benchmark number. Суждение, которое раньше было слишком дорогим для каждой строки, может переехать в обычный data pipeline.
Real-time интерфейсы
- Выбирать следующее browser action из известных page elements.
- Оценивать tone или clarity, пока человек пишет.
- Выбирать action из structured game или simulator state.
Сегодня Jev text-only, поэтому такие системы сначала должны преобразовать environment в text или JSON. Он не смотрит на экран и не играет по pixels.

Где Jev — неправильный выбор
Jev становится менее полезен, как только пространство ответов перестаёт быть известным.
- Он не может написать ответ, суммаризировать документ, сгенерировать код или объяснить reasoning.
- Он ненадёжен для arithmetic, counting, date comparison или exact string manipulation. Оставляйте эти операции в коде.
- Ему трудно там, где решение требует нескольких скрытых reasoning steps. Разбейте суждение на меньшие вопросы или используйте reasoning model.
- Он не может напрямую извлечь неизвестное значение. Сначала найдите candidate values, затем дайте Jev выбрать среди них.
- Irrelevant context может снизить accuracy. Отправляйте только state, нужный для решения.
- Closed weights, early access, text-only input и ограниченные independent calibration data делают слепое доверие преждевременным.
Есть и более простое правило: если deterministic code уже решает задачу корректно, оставьте код. Обычный if statement быстрее, дешевле и проще для тестирования, чем любая модель.
Как использовать Jev, не создавая новый failure mode
Дешёвая модель всё равно может оказаться дорогой, если её ошибки создают retries, manual review или production incidents. Измеряйте весь workflow, а не token price.
Разумный rollout выглядит так:
- Выберите одно bounded, low-risk решение с понятными возможными ответами.
- Напишите rubric до вызова модели. Определите, что относится к каждому варианту.
- Соберите representative examples с expected answers, включая ambiguous и adversarial cases.
- Запустите Jev в shadow mode рядом с текущим workflow, не позволяя ему менять behavior.
- Постройте accuracy against confidence и задайте thresholds по своим данным.
- Автоматизируйте сначала самую безопасную ветку, а для uncertain cases оставьте человека или более сильную модель.
- Pin или log model version, questions, criteria и thresholds, чтобы изменения можно было replay against тот же evaluation set.
Вопросы — часть программы. Относитесь к ним как к коду: version them, review them и тестируйте при каждом изменении модели или rubric.

Настоящий сдвиг
Jev интересен не потому, что побеждает LLM в письме. Он отказывается писать.
Его вклад — model interface, сформированный как software: fixed answer types, explicit uncertainty, parallel questions и code-controlled branching.
Это делает его полезным companion для generative models. LLM производит plan, explanation или code. Jev routes request, gates risky action, checks result и решает, когда uncertainty достаточно высока для escalation.
Более широкая идея важна, даже если Jev позже заменит другая модель. Мы годами просили generative models выполнять все виды intelligence через text. Многим production systems не нужно больше слов. Им нужно маленькое быстрое суждение, которое ordinary software может безопасно использовать.
Именно эту категорию Jev пытается построить.
С чего начать
Не начинайте с перестройки всего агента вокруг Jev. Найдите одно решение, которое сейчас требует медленного LLM call или regex, который постоянно ломается.
Дайте Jev minimum state, определите possible answers и логируйте его probabilities рядом с текущим результатом. Пусть он докажет, что заслуживает одну ветку, прежде чем вы доверите ему весь workflow.
Самая полезная mental model остаётся самой простой: Jev добавляет judgment там, где обычный if statement понимает значения, но не их meaning.
Источники и дополнительное чтение
- TypeSafe AI: Introducing System One Models and Jev
- LangChain: Building a Harness with Jev
- Flavio Copes: A deep dive into Jev
Надеюсь, вам было интересно читать.
Увидимся в следующем материале.
Cheers! :)