
LLM с нуля: от чат-бота 1966 года до Grok 4.5 и Kimi K3
Полный перевод X Article о пути LLM от ELIZA и PARRY к трансформерам, RLHF, Grok 4.5, Kimi K3, MoE и проблеме интерпретируемости.
Оригинал опубликован Eron в X Article. Повод для импорта: пост fintex с 18-минутным видео о масштабировании и lottery ticket hypothesis. Оригинальное видео.
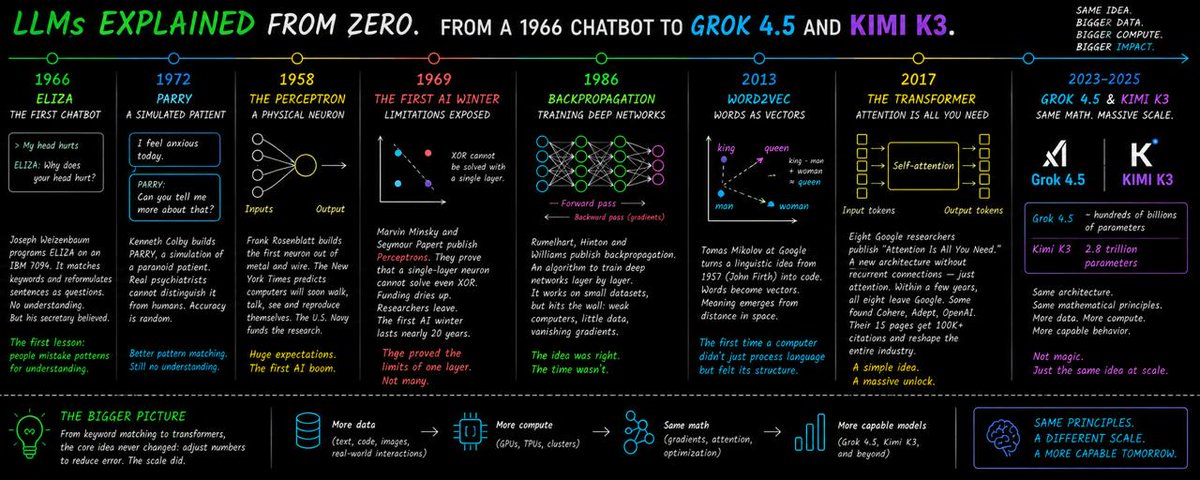
В 1966 году Джозеф Вейценбаум сделал то, чего сам не ожидал. Он запрограммировал IBM 7094 так, чтобы машина отвечала как психотерапевт. Назвал программу ELIZA. И оставил ее наедине со своей секретаршей.
Через несколько минут она попросила его выйти из комнаты. Ей хотелось поговорить с ELIZA наедине.
Вейценбаум был ошеломлен. Не потому, что ELIZA была разумной. А потому, что она совершенно не была разумной. Программа просто искала ключевые слова и переформулировала фразы в вопросы. "У меня болит голова" -> "Почему у вас болит голова?" Никакого понимания. Никакой памяти. Ни одна строка кода не знала, что такое "голова". Но секретарша поверила.
Это был первый урок, который люди упорно отказывались выучить следующие семьдесят лет.
В 1972 году Кеннет Колби в Стэнфорде пошел дальше. Он создал PARRY - симуляцию пациента с паранойей. Затем попросил настоящих психиатров отличить PARRY от реальных людей в текстовых интервью. Они не смогли. Точность оказалась на уровне случайного угадывания. Психиатры с годами клинической практики были обмануты программой на правилах, работавшей на университетском мейнфрейме.
Но PARRY ничего не понимал. Он имитировал паттерны лучше, чем ELIZA. В этом и заключалась вся разница.
В Корнеллском университете Фрэнк Розенблатт строил первый нейрон из металла и проводов. 1958 год. Перцептрон - физическая машина размером с комнату, которая училась распознавать буквы. The New York Times писала, что компьютеры скоро будут ходить, говорить, видеть и воспроизводить самих себя. ВМС США финансировали исследование. Розенблатт появлялся на обложках журналов.
Одиннадцать лет спустя Марвин Минский и Сеймур Пейперт одной книгой убили всю индустрию. "Перцептроны", 1969 год. Они математически доказали, что однослойный нейрон не способен решить даже простую задачу XOR. Финансирование иссякло. Исследователи ушли в другие области. Заявки на гранты оставались без ответа. Первая зима ИИ продлилась почти двадцать лет.
Но в одном они ошибались. Они доказали ограничения одного слоя. Не многих.
В 1986 году Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс опубликовали работу, которая должна была изменить все. Backpropagation - алгоритм, позволивший обучать глубокие сети слой за слоем. Математика была элегантной. Идея была революционной. И какое-то время она работала: на маленьких датасетах, в контролируемых экспериментах, на аккуратно собранных бенчмарках.
Затем она уперлась в стену. Компьютеры были слишком слабыми. Данных в нужном масштабе не было. Проблема затухающего градиента делала глубокие сети нестабильными. Алгоритм существовал, но его нельзя было применить ни к чему реальному в масштабе. Последовала еще одна зима - тише первой, но столь же разрушительная для области.
Затем в 2013 году Томас Миколов в Google создал word2vec. Идея, которую лингвист Джон Ферт сформулировал еще в 1957-м - "слово узнается по окружению", - внезапно стала вычислимой. King минус Man плюс Woman равно Queen. Слова превратились в векторы в пространстве. Расстояние между векторами стало означать что-то реальное. Синонимы группировались вместе. Антонимы располагались предсказуемо далеко. Страны оказывались рядом со своими столицами.
Это был первый момент, когда компьютер не просто обрабатывал язык, а как будто ощущал его структуру.
Но чего-то все еще не хватало.
15 июня 2017 года восемь исследователей Google опубликовали пятнадцатистраничную статью. "Attention Is All You Need". Они предложили архитектуру без рекуррентных связей, без сверточных сетей - только механизм внимания. Трансформер.
За несколько лет все восемь ушли из Google. Кто-то основал Cohere. Кто-то перешел в Adept. Кто-то - в OpenAI. Один из авторов подписал статью в пятницу, а уже в следующем году ушел. Эти пятнадцать страниц набрали больше ста тысяч цитирований и перестроили всю технологическую индустрию.
Механизм внимания - не метафора. Когда модель читает фразу "Банк отказал в кредите, потому что они сочли бизнес рискованным", ей нужно понять, что "они" относится к "банку", а не к "бизнесу". Для этого каждое слово отправляет query: с кем я связано? Другие слова отвечают key. Модель вычисляет сходство между каждым query и каждым key, нормализует результат через softmax и взвешивает values.
Это происходит параллельно для всех слов одновременно. Не последовательно, как мозг, читающий слово за словом, а сразу: все предложение обрабатывается как единая структура.
Архитектура масштабировалась так, как никто полностью не предвидел. Больше слоев давало лучшие представления. Больше параметров - более широкие знания. Больше данных - более богатые статистические паттерны. GPT-3 в 2020 году перешагнула отметку в 175 миллиардов параметров. Модель могла писать эссе, код, стихи, юридические документы и медицинские сводки без дообучения под каждую из этих задач. Просто prompt и response.
Но один только масштаб не решил проблему поведения. Модель, оптимизированная исключительно на предсказание, училась генерировать правдоподобный текст независимо от того, был ли он истинным, полезным или связным на протяжении долгого разговора.
RLHF - reinforcement learning from human feedback, обучение с подкреплением по человеческой обратной связи - изменило это. Сначала модель генерирует ответы. Люди ранжируют их от лучших к худшим. Отдельная reward-модель обучается на этих ранжированиях и учится предсказывать человеческое предпочтение. Затем основная модель оптимизируется так, чтобы максимизировать reward. Именно это превратило статистическую машину предсказания следующего токена во что-то, с чем действительно можно разговаривать. Во что-то, что способно следовать инструкциям, поддерживать персону и отказывать в запросах, которым ее научили отказывать.
Это не было пониманием. Но снаружи выглядело именно так.
Сегодня Grok 4.5 от xAI работает на базовой модели с 1,5 триллиона параметров - архитектуре девятого поколения, V9. Модель нативно интегрируется в Cursor: не через API-прокси, а напрямую в среду IDE. Она выдает 85 токенов в секунду с гарантированным SLA. Контекстное окно - 500 000 токенов, в дорожной карте - миллион. Цена: 2 доллара за миллион входных токенов и 6 долларов за миллион выходных.
Это не самая дорогая модель на рынке. Но на измеряемых бенчмарках она превосходит все open-weight модели и напрямую конкурирует с закрытыми frontier-системами. Она находится выше большинства открытых моделей и ниже самых верхних закрытых - позиция, которая делает ее практически самой интересной моделью для разработчиков прямо сейчас, потому что с соотношением цены и качества в масштабе трудно спорить.

Тем временем в Китае Moonshot AI в июле 2026 года выпустила Kimi K3. Не как очередной масштабированный трансформер по той же схеме, а как архитектурный аргумент о том, где вычисления действительно должны происходить. Исходная предпосылка была иной: большая часть знания, закодированного в модели, не нужна для большинства запросов. Зачем активировать все, если требуется лишь доля?
Kimi K3 содержит 2,8 триллиона параметров всего, но активирует только 104 миллиарда на токен. Это Mixture of Experts - 896 специализированных подсетей, из которых в каждый момент включаются только 16. Каждый токен маршрутизируется к экспертам, которые с наибольшей вероятностью справятся с ним хорошо. Остальные простаивают, их веса для данного ввода не трогаются.
Механизм маршрутизации - место, где исторически ломалось большинство MoE-моделей. Достаточно долго обучайте их, и роутер начинает схлопываться: отправляет все к одним и тем же нескольким экспертам, игнорируя остальных. Kimi K3 решает это через Stable LatentMoE - метод стабилизации на этапе обучения, который удерживает использование экспертов сбалансированным по всему пулу из 896 экспертов без явных штрафов за балансировку нагрузки, ухудшающих качество модели.
69 из 93 слоев K3 используют KDA - Kernel-based Dense Attention. Вместо классического вычисления внимания по полной матрице KDA аппроксимирует сходство через kernel-функции в компактном пространстве. Математика обменивает небольшую потерю теоретической точности на сильное снижение вычислительной стоимости - особенно на длинных контекстах, где классическое внимание становится запретительно дорогим.
Оставшиеся 24 слоя используют Gated MLA - вариант Multi-head Latent Attention, в котором входные последовательности проходят через обучаемые gates до вычисления внимания. Модель решает слой за слоем, что заслуживает детальной обработки. Это не трюк компрессии. Это структурное утверждение: не каждый токен вносит одинаковый вклад в каждое предсказание, и архитектура должна это отражать.
Контекстное окно составляет 1 048 576 токенов. Больше миллиона. Обучение использует смешанную точность MXFP4 и MXFP8 вместо стандартного float32 - решение, которое позволяет обучать модель в 28 раз больше без пропорционального роста затрат и влияет также на эффективность инференса.
Но вернемся к главному вопросу, который каждый исследователь задавал с 1950 года: что такое понимание?
Алан Тьюринг предложил обойти вопрос. Если машина ведет разговор неотличимо от человека - важно ли, понимает ли она? Его тест требовал только поведения, а не внутреннего состояния. Вейценбаум всю оставшуюся карьеру доказывал, что это неправильный вопрос или как минимум неполный. Люди проецируют понимание на все, что отвечает похожим образом. Мы видим лица в облаках. Мы слышим эмпатию в коде. Это не изъян машины - это то, как работает человеческое восприятие.
Токенизация - первый слой абстракции, из-за которого все это перестает ощущаться простой проекцией. Byte Pair Encoding, метод, изобретенный Филипом Гейджем в 1994 году для сжатия данных и адаптированный для NLP в 2015-м, разбивает текст не на слова и не на буквы, а на подсловные единицы, размер которых определяется тем, как часто они встречаются вместе. GPT-4 работает со словарем примерно из 100 000 таких единиц.
Каждый токен становится вектором в высокоразмерном пространстве - в тысячах измерений, где позиция кодирует значение через статистические паттерны, выученные на миллиардах предложений.
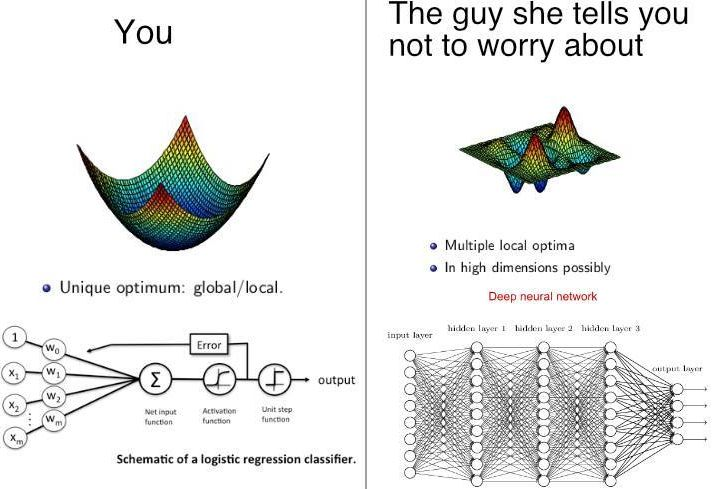
Механизм внимания вычисляет, как эти векторы взаимодействуют. Матрицы Q, K, V - query, key, value - обучаются независимо. Произведение Q и транспонированной K делится на квадратный корень из размерности, проходит через softmax и умножается на V. Результат: новое представление каждого токена, взвешенное всем остальным в контекстном окне. Прогоните это через десятки слоев. Поставьте сверху feed-forward сети. Повторите на миллиардах токенов во время обучения. Возникает модель, способная производить текст, статистически согласованный со всем, что написали люди.
Чего она не может - так это сказать вам почему. Не надежно.
Интерпретируемость остается одной из наименее решенных проблем области. Карты внимания можно наблюдать. Активации нейронов можно логировать. Но превратить эти наблюдения в причинные объяснения - настоящий отчет о том, почему модель сказала именно это, - ни одна исследовательская команда пока не продемонстрировала в масштабе.
Grok 4.5 не объясняет свои выводы. Kimi K3 со своей системой маршрутизации из 896 экспертов активирует конкретные 16 экспертов для каждого токена - и сам этот выбор не является человеко-интерпретируемым в прямом смысле. Роутер выучил, какие эксперты обрабатывают какие типы входов, по результатам обучения, а не по правилу, написанному человеком. Решение происходит. Причина не всплывает на поверхность.
Та же структурная непрозрачность, что и у ELIZA. Мы видим выход. Мы проецируем на него смысл.
Разница в том, что выход стал ошеломляюще точнее всего, что было раньше.
Семьдесят четыре года между тестом Тьюринга и Kimi K3. Этот промежуток - не линейная история о том, как лучшие алгоритмы постепенно улучшаются. Это серия совершенно разных ставок на то, чем язык является в своей основе. Символьная манипуляция в 60-х. Вероятностные модели в 90-х. Глубокие нейросети в 2010-х. Масштаб вычислений и данных с 2020 года. Архитектурная эффективность - разреженная активация, kernel attention, смешанная точность - определяет 2026-й.
Каждое поколение думало, что нашло ответ. Каждое поколение находило что-то настоящее и принимало это за всю картину.
Новые модели теперь обучаются на тексте, частично сгенерированном предыдущими моделями. Синтетические данные входят в обучающий pipeline каждой крупной лаборатории. Никто не знает наверняка, как эта рекурсия меняет статистическую структуру языка, которую выучит следующее поколение. Это петля обратной связи без внешней истины, которая могла бы ее заякорить.
Секретарша Вейценбаума попросила его выйти из комнаты. Она хотела приватности с программой, которая ничего не понимала. Вейценбаум десятилетиями спрашивал, что этот момент говорит о людях, а не о машинах.
В 2026 году модель с 2,8 триллиона параметров обрабатывает больше миллиона токенов контекста и отвечает точнее всего, что люди строили до нее.
Вопрос секретарши так и не получил ответа. Его просто стало труднее отмахнуть.