
Как на самом деле думает GPT 6 Astra
Полный перевод X Article о том, как зацикленная архитектура GPT 6 Astra меняет вычислительную глубину модели.
Источник: https://x.com/Mikadzyki_NFT/status/2097336663429046689
Автор: Mikadzyki
OpenAI описывает GPT 6 Astra как свою самую способную и выровненную модель на данный момент.
Грег Брокман пошел дальше и сказал, что Astra разумно рассматривать как раннюю форму искусственного общего интеллекта.
Модель также первой преодолела критический порог OpenAI в области кибербезопасности. По словам компании, она способна находить ранее неизвестные уязвимости и создавать рабочие эксплойты при ограниченном участии человека.
Эти заявления звучат громко, но не они являются самой важной частью релиза.
Настоящее изменение связано с архитектурой.
Обычная языковая модель пропускает информацию через фиксированную последовательность трансформерных блоков и генерирует следующий токен. Astra может многократно обрабатывать свое внутреннее состояние через одни и те же вычислительные блоки, прежде чем показать пользователю хотя бы одно слово.
Она не просто генерирует более длинную цепочку рассуждений.
Она тратит больше времени на мышление до ответа.
1. Как работают современные языковые модели
Представьте, что вы набираете:
Everest is...
Модель должна предсказать, что будет дальше.
Механизм внимания определяет, какие части контекста важны. Слово Everest активирует связанные понятия: горы, высота, Гималаи, Непал, Тибет, альпинизм и экспедиции.
Затем модель объединяет эти ассоциации с окружающим контекстом. В большинстве случаев продолжение вроде "the highest mountain on Earth" становится очень вероятным.
Внутри обычного трансформера это представление проходит через последовательность блоков. Каждый блок один раз преобразует его и передает результат следующему.
Если в модели 40 блоков, скрытое состояние проходит через все 40 последовательно. Финальное представление преобразуется в распределение вероятностей для следующего токена.
Больше блоков обычно означает большую вычислительную глубину. Более глубокая модель может выполнить больше преобразований, прежде чем зафиксировать ответ.
Но добавление блоков также увеличивает число параметров, требования к памяти и стоимость обучения.
Обычное предположение было простым: если нужна более глубокая модель, нужно строить более высокий стек слоев.
Зацикленная архитектура меняет этот принцип.
2. Что меняет зацикленная архитектура
По данным The Information, GPT 6 Astra использует зацикленную архитектуру трансформера.
OpenAI не публиковала полную техническую спецификацию, поэтому точная реализация остается закрытой. Но общий механизм уже хорошо понятен по открытым исследованиям.
Вместо того чтобы пропускать скрытое состояние через каждый блок только один раз, модель может вернуть результат в вычислительный блок и обработать его снова.
Думайте об этом как о внутреннем черновике.
Модель создает предварительное представление, снова пропускает его через те же веса, уточняет и повторяет процесс несколько раз. Только после завершения цикла появляется следующий видимый токен.

Число параметров остается тем же. Веса остаются внутри одного блока, вычисления растут вместе с числом циклов, а наружу выводится только финальный токен.
Ключевая деталь в том, что число параметров не обязательно увеличивается.
Одни и те же веса используются повторно на каждом проходе.
Растет именно объем вычислений.
В обычном трансформере токен проходит через последовательность разных блоков. В зацикленном трансформере он может несколько раз пройти через одну и ту же общую структуру.
Модель становится глубже за счет вычислений, не становясь больше по числу параметров.
Это создает новый компромисс:
- больше параметров требует больше памяти
- больше циклов требует больше вычислений
- одна модель может тратить разный объем compute на разные задачи
Последний пункт особенно важен. Вычислительная глубина может меняться без создания новой модели.
3. Как обучают рекуррентную глубину
Просто поместить трансформерный блок в цикл недостаточно.
Если модель всегда выполняет ровно 32 прохода во время обучения, она может научиться опираться на позицию каждого шага. Первый проход может выучить одну функцию, десятый другую, а тридцать второй стать фиксированным выходным слоем.
В результате получится обычная 32-слойная сеть, замаскированная под цикл.
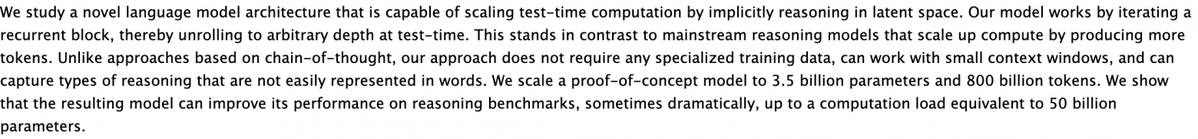
Исследователи решают эту проблему, изменяя число рекуррентных проходов во время обучения.
Одна из самых наглядных демонстраций появилась в модели рекуррентной глубины Huginn. Ее авторы обучили сеть на 3,5 млрд параметров примерно на 800 млрд токенов.
На каждом шаге обучения число циклов выбиралось из распределения со средним около 32. Один пример мог получить четыре прохода, другой 17, третий 40, а еще один почти 90.
Модель не могла заранее знать, какой проход будет последним.
Поэтому ей приходилось учиться чему-то более общему, чем фиксированная последовательность операций.
Ей нужно было научиться улучшать свое текущее внутреннее состояние.
Обучение через десятки рекуррентных шагов создает еще одну проблему: память.
Стандартное обратное распространение ошибки потребовало бы хранить промежуточные активации каждого цикла. При большом числе повторений стоимость памяти становится огромной.
Исследователи Huginn использовали практический компромисс. Прямой проход мог выполняться много циклов, но градиенты считались только через последние восемь.
Более ранние проходы все равно влияли на финальный результат, но их полная история активаций не должна была оставаться в памяти.
Это похоже на усеченное обратное распространение во времени. Разница в том, что рекуррентность возникает не между словами в последовательности, а по вычислительной глубине.

Число циклов выбирается на каждом шаге обучения, а градиент считается только через последние восемь проходов.
Модель не учат выполнять жесткую последовательность из 32 операций.
Ее учат двигать скрытое состояние к полезному ответу независимо от того, в какой момент процесс остановят.
Это меняет само значение глубины.
Глубина больше не только свойство, выбранное инженерами до обучения. Она может стать переменной во время инференса.
4. Адаптивные вычисления во время инференса
Большинство нынешних способов управления рассуждением работают на уровне видимых токенов.
Если модель просят подумать дольше, она генерирует более длинную цепочку рассуждений, использует больше выходных токенов или создает дополнительный промежуточный текст.
Зацикленная архитектура предлагает другой механизм.
Число внутренних проходов может меняться без изменения весов и без необходимости заставлять модель писать более длинное объяснение.
Простая задача может получить четыре цикла.
Сложное математическое доказательство может получить 32.
Сложная задача по программированию может получить 64.
Модель остается той же. Меняется только объем внутренних вычислений.

Веса остаются фиксированными. Меняется только число внутренних проходов, используемых для обработки каждого токена.
Открытые эксперименты с рекуррентной глубиной уже показывают ожидаемый паттерн.
Качество быстро растет на первых циклах. Затем приросты становятся меньше, пока кривые не приближаются к плато.
Это говорит о том, что скрытое состояние сходится.
Ранние проходы вносят крупные исправления. Поздние уточняют мелкие детали. В конце дополнительные вычисления перестают давать заметную пользу.
Будущая система могла бы определять этот момент автоматически.
Вместо того чтобы задавать каждому запросу фиксированное число циклов, модель могла бы продолжать обработку до тех пор, пока ее скрытое состояние не станет достаточно стабильным. Простые токены были бы дешевыми. Сложные получали бы больше compute.
Так появилась бы настоящая адаптивная вычислительная глубина.
Думать дольше больше не обязательно означало бы писать больше.
5. Исследования и первые практические результаты
Повторное использование трансформерных слоев не новая идея.
Universal Transformers ввели рекуррентную обработку в 2018 году. ALBERT уменьшил число параметров за счет совместного использования весов между слоями. Mixture of Recursions исследовала маршрутизацию токенов через разный объем вычислений.
Открытая модель Nanbeige4.2 3B дает особенно прямой пример.
В ее конфигурации указано 22 слоя и num_loops: 2. По сути, модель проходит через эти слои дважды. У нее примерно столько же параметров, сколько у сети с 22 слоями, но вычислительная глубина примерно как у сети с 44 слоями.

Двадцать два слоя, num_loops: 2 и лицензия Apache 2.0. Механизм уже виден в конфигурации открытой модели.
Многие годы рекуррентные трансформеры оставались интересными исследовательскими идеями, а не доминирующим подходом.
Не хватало убедительных данных о масштабировании.
1 сентября группа исследователей опубликовала SMELT — работу, нацеленную на сравнение зацикленных и обычных трансформеров при сопоставимых условиях.
Они контролировали число параметров, compute обучения и размер KV-cache. При этих ограничениях зацикленным моделям требовалось на 6,8-18% меньше compute обучения, чтобы достичь того же уровня качества.
Самый большой выигрыш появился на коде.

При сопоставимых compute, параметрах и KV-cache циклы экономят 6,8-18% compute обучения, причем самый сильный эффект виден на коде.
Исследователи также заметили изменение поведения внимания.
В обычных трансформерах самые ранние токены в последовательности часто становятся "стоками внимания". Они получают непропорционально много внимания, даже когда их смысловая важность ограничена.
После второго прохода через те же блоки внимание модели смещалось к более релевантным токенам.
Второй цикл не просто повторял первый. Он использовал результат первого прохода как основу для более избирательной обработки.
SMELT не доказывает, что каждая будущая модель должна быть рекуррентной. Но работа показывает, что циклы остаются конкурентоспособными после выравнивания основных экспериментальных условий.
Вопрос уже не в том, может ли рекуррентная глубина работать.
Вопрос в том, насколько далеко ее можно масштабировать.
6. Интерпретируемость и контроль
Та же архитектурная особенность, которая делает циклы привлекательными, усложняет мониторинг модели.
При явной цепочке рассуждений хотя бы часть промежуточных шагов появляется как читаемый текст. Исследователи могут их проверять, искать подозрительные паттерны и сравнивать заявленное рассуждение с итоговым ответом.
Рекуррентная модель может выполнять больше обработки внутри скрытых активаций, не генерируя текста.
Бак Шлегерис и Райан Гринблатт утверждали, что это может снизить полезность мониторинга chain-of-thought. Если больше обработки уходит в скрытые вычисления, видимое объяснение может меньше рассказывать о том, как модель пришла к результату.
Себастьян Рашка предложил важное возражение.
Повторное использование весов не создает автоматически тайное или недоступное мышление. Внутренние активации все еще можно изучать инструментами интерпретируемости. Главное отличие в том, что модели может понадобиться меньше видимых промежуточных токенов, потому что больше вычислений происходит до начала генерации.
Главный ученый OpenAI Якуб Пачоцки также говорил, что вычислительный граф Astra остается примерно в пределах двукратной глубины GPT 4, а цикл намеренно ограничен ради сохранения возможностей мониторинга.
Это указывает скорее на сдержанную реализацию, чем на неограниченный рекуррентный процесс.
Chain-of-thought в принципе не гарантирует точной расшифровки внутреннего вычисления модели. Система получает награду за полезные ответы, а не за научно точный отчет о каждом скрытом шаге.
Исследования OpenAI, Anthropic и Google DeepMind показывают, что объяснение модели может упускать важные факторы, рационализировать решение постфактум или показывать более чистый путь, чем тот, который на самом деле повлиял на результат.
Зацикленная архитектура делает это различие труднее игнорировать.
Видимое рассуждение может быть интерфейсом.
Основные вычисления могут происходить внутри модели до появления любого текста.
7. Результаты GPT 6 Astra
Самый эффектный бенчмарк GPT 6 Astra — результат 99,9% на ARC AGI 3.
Число выглядит почти финальным, но оно сильно зависит от того, как именно запускается тест.
Саймон Уиллисон отметил, что результат 99,9% был получен в кастомном harness OpenAI Provider Adapter. В стандартном ARC Prize harness та же модель набрала 62,7%.
Модель не изменилась.
Изменилась среда оценки.

Одна и та же модель дает два разных результата при двух разных стоимостях запуска.
Запуск OpenAI стоил примерно $19 000. Стандартный запуск стоил примерно $26 000.
Значительно более высокий результат был получен более дешевым способом.
Это не обязательно делает результат недействительным. Кастомный адаптер может эффективнее взаимодействовать с моделью или раскрывать способности, которые пропускает универсальная оценочная среда.
Но заголовочное число нельзя интерпретировать отдельно от условий, в которых оно было получено.

Одна модель, два оценочных harness и разрыв в 37,2 процентного пункта.
Другие оценки менее драматичны.
В Artificial Analysis Intelligence Index Astra находится примерно на уровне GPT 5.6 Sol и примерно на пять пунктов ниже Claude Fable 5.1.
Ее более практическое преимущество может быть в эффективности на агентных задачах, где она способна достигать конкурентного качества с меньшей стоимостью.
Бенчмарки показывают, чего может достичь модель. Архитектура помогает объяснить, откуда берутся эти способности и как они могут развиваться.
8. Что это значит для будущего ИИ
Многие годы масштабирование языковых моделей в основном означало добавление параметров, добавление данных и построение более крупных фиксированных стеков трансформерных блоков.
Каждое новое поколение становилось больше, дороже и требовательнее к запуску.
GPT 6 Astra указывает на другой путь.
Модель может повторно использовать одни и те же параметры, выделять больше вычислений сложным задачам и уточнять свое внутреннее представление до того, как произнесет первое слово.
Это отделяет размер модели от глубины ее рассуждения.
Вместо одного фиксированного вычислительного пути система может подстраивать объем работы под сложность конкретной задачи.
Это может изменить и качество моделей, и экономику использования ИИ. Один и тот же интеллект сможет работать в быстром и дешевом режиме для простых запросов, а затем увеличивать вычислительную глубину, когда задача действительно требует большего рассуждения.
Рекуррентность возвращается в языковые модели. На этот раз она действует не столько между словами, сколько внутри процесса, который их создает.
Следующее поколение систем может стать сильнее не только потому, что содержит больше параметров.
Их определяющим преимуществом может оказаться способность понимать, когда хороший ответ уже найден, а когда стоит пройти внутренний цикл еще раз.
Источники
- анонс OpenAI о GPT 6 Astra
- Грег Брокман о GPT 6 Astra и AGI
- GPT 6 Astra и критический порог кибербезопасности
- список материалов по deep learning, рекомендованный Ильей Суцкевером
- материал The Verge об Astra и зацикленных трансформерах
- Scaling up Test Time Compute with Latent Reasoning
- Mixture of Recursions
- Nanbeige4.2 3B на Hugging Face
- SMELT Scaling Laws for Compute Matched MoE Looped Transformers
- опасения AI safety вокруг архитектуры рассуждения Astra
- анализ Себастьяна Рашки об Astra и зацикленных трансформерах
- Chain of Thought Monitorability
- анализ Саймона Уиллиссона о GPT 6 Astra